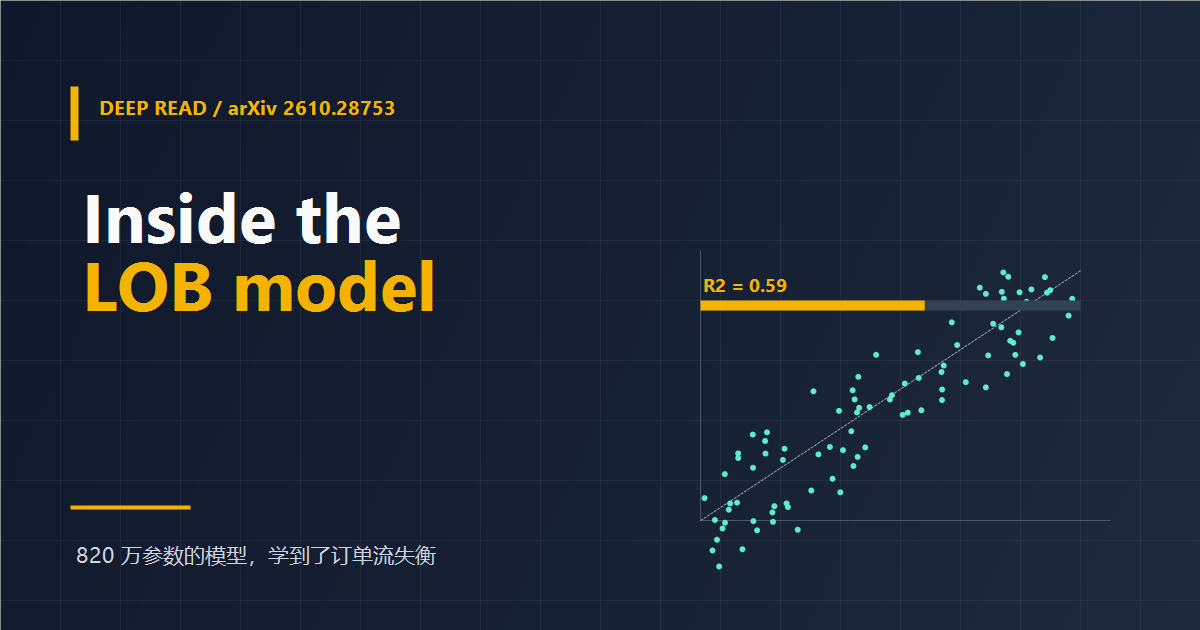
模型的脑子里有一张订单簿:820 万参数的世界模型,把订单流失衡解码到 R²≈0.59
一个能生成订单簿的模型,和一个理解订单簿的模型,看起来一样,实际上是两件事。这篇论文做的是把它们分开。
01问题:生成得像,和真的懂,是两件事
先区分两个目标。第一个是「模拟」:给模型一段订单簿历史,让它继续生成后续的消息流,要求生成的序列在价差分布、成交间隔、订单规模这些统计量上接近真实。第二个是「理解」:模型内部是否形成了一个关于市场状态的表示,比如当前买方压力有多大、流动性薄在哪一侧。
这两个目标经常被混为一谈,因为模拟得好通常意味着某种理解,但反过来不成立:一个记住了「上午 9:35 之后通常会有更多市价单」的模型,可以生成很像的序列,却完全没有「失衡」这个概念。对做交易的人,这个区别很实际:如果模型只是模仿,你没法用它做反事实——「如果这时来一笔大买单,价格会怎么走」这种问题,模仿型模型答不了。
作者把问题写得很直白。
This study therefore asks what these models actually learn about market microstructure.原文
注释:注意「actually」这个词。它不是「模型效果如何」,而是「模型里面到底有什么」。这类研究在机器学习里叫机制可解释性(mechanistic interpretability),在金融领域的应用还很少。
为什么挑订单流失衡(order-flow imbalance, OFI)作为探针?因为在微观结构文献里,OFI 是短周期价格变动最稳定的解释变量之一:主动买单与主动卖单的差额,能在秒级解释相当一部分价格变化。如果一个模型真的学到了市场状态,它应该「知道」当前的 OFI;如果它只是模仿消息的统计节拍,这个量就不一定在它的表示里。
02方法:把消息流当语言,再用探针去读
模型侧的做法是把订单簿的每一条消息(新增限价单、撤单、市价成交)离散成 token,像语言模型那样自回归预测下一条。用的是 Mamba-3 状态空间结构,参数量 8.2M——按今天的大模型标准非常小,小到可以在单机上跑,这也是它能被逐层分析的前提。
an 8.2M-parameter Mamba-3 state-space model trained autoregressively on the tokenized message stream of eight large-cap US equities learns an internal representation of the market and its dynamics.原文
注释:「学习到了内部表示」这句话本身是结论,不是前提。它的证据在下一段:用线性探针从隐藏状态里解码 OFI。这里要注意 8.2M 这个数字——它不是「小模型也能做到」的宣言,而是「小到可以被完整检查」的实验设计选择。
探针(probe)的做法是:冻结模型,取它在每个时间步的隐藏状态,训练一个简单的线性回归去预测当期 OFI。如果线性探针就能拿到高 R²,说明这个信息以近似线性的方式编码在状态里;如果必须用很复杂的探针才读得出来,那更可能是探针自己学会了任务,而不是模型里本来就有。
这套方法有一个天然的对照:把同样的探针接到随机初始化的模型、或者接到只见过打乱顺序数据的模型上,R² 应该接近 0。论文说 0.59「远高于对照与基线」,但没有在摘要里给出对照的具体数值——这是读摘要时要知道的缺口。
03三个结果:读得出、带得走、推得动
第一个结果是解码精度。
order-flow imbalance, a central driver of short-horizon price moves, is decodable at R^2 ≈ 0.59, far above controls and baselines.原文
注释:R²=0.59 是一个「明显但不完全」的数字。它说明模型的状态里确实有 OFI 的信息,而且是以相对简单的形式存在;但它也说明有四成左右的变异不在这个线性可读的方向上。第 04 节会把这两个含义都算清楚。
第二个结果是迁移。
This representation extends to unseen stocks, suggesting that these models learn general representations rather than ticker-specific patterns.原文
注释:这条比 0.59 更有分量。如果表示只对训练过的八只股票有效,那它可能只是记住了每只股票的「指纹」;能迁移到新股票,才说明它抓到的是订单簿的通用结构(比如「买方深度变薄之后更容易上涨」)。当然,「扩展到未见股票」的具体口径——是零样本探针,还是少量微调——摘要没写,需要看正文。
第三个结果是可操纵性,也是全文最有野心的一步。
the representation is causally steerable: pushing the state along a feature’s axis shifts the model’s next-message beliefs as that feature implies, monotonically in dose, consistent with the emergence of a world model.原文
注释:「可操纵」比「可解码」强一个层级。能读出 OFI,只证明信息在那里;能沿着 OFI 的方向推动状态、并让模型的预测按预期改变,才说明模型在生成时真的用到了这个量。而「单调 in dose」是关键的严谨性:推动得越多,预测偏得越多,这排除了「碰巧方向对」的解释。
三个结果连起来,构成了一个完整的论证链:信息在(可解码)、结构是通用的(可迁移)、并且被使用(可操纵)。这也是作者敢用「world model」这个词的理由。
04我们的复算:R²=0.59 到底剩下多少
R² 是一个容易被读高的数字。0.59 听起来「接近六成」,但换成相关系数和残差,感受会不一样。
| 指标 | 数值 | 含义 |
|---|---|---|
| R² | 0.59 | 解释了 59% 的方差 |
| 相关系数 |r| | 0.768 | 线性相关程度 |
| 未解释方差 | 41% | 探针读不到的部分 |
| 残差标准差 | 原始的 64% | 单次预测的典型误差 |
| 若用于冲击估计 | 误差同比例传导 | OFI→价格的系数误差会放大 |
为什么残差 64% 这件事重要?因为 OFI 在实务里几乎总是作为一个线性因子进入价格冲击模型:ΔP ≈ k × OFI。如果模型的内部表示只能还原 59% 的 OFI 方差,那么用它做「反事实模拟」时,冲击估计的误差不会小于这个量级。这不是模型的缺陷,而是「用 8.2M 参数的状态做压缩」的必然代价——压缩一定丢信息,问题是丢的是不是关键的那部分。
再看「单调 in dose」这条证据有多强。假设作者测试了五个推力档位,如果模型对 OFI 毫无概念,那么五档的预测偏移方向应当是随机的,全部同向的概率是 2 × (1/2)^5 = 6.25%。论文没有在摘要里给档位数,这里只是说明这类「单调性」证据的统计含义:它不需要很大的样本,就能排除「瞎猜」。
还有一个值得自己算的比例:8.2M 参数,对应八只股票的消息流。如果每只股票每天约百万级消息、训练数月,token 总量在十亿量级,那么参数量与数据量的比值大约是 1:100 以上——这是典型的「数据远多于参数」区间。这个区间里,模型不太可能靠死记硬背通过迁移测试,这也侧面支持了「通用表示」的说法。
05反例与边界:读得出,不等于用得上
第一,探针读到的东西,可能只是「过去」,不是「预测」。OFI 是一个当期可观测的量,模型在生成下一条消息时当然需要知道刚发生了什么。能解码当期 OFI,说明状态里保留了近期订单流的历史;这不等于模型能预测未来的 OFI 或价格。论文的可操纵实验部分回应了这个质疑,但「能推动预测」和「推动后预测更准」仍是两件事。
第二,八只大盘股是一个很窄的样本。大盘股的订单簿有厚深度、小价差、大量算法挂单;小盘股、加密永续、新兴市场的订单簿结构完全不同。迁移测试只证明了「在美股大盘股之间迁移」,不能外推到其他市场。
第三,8.2M 参数的模型能学到什么,不能直接推广到几十亿参数的生产模型。大模型可能学到更丰富的表示,也可能学到更多与任务无关的捷径;可解释性工具本身的成本会随规模上升。把这篇的结论当成「所有订单簿基础模型都懂市场」,是过度解读。
第四,「世界模型」是一个有分量的词,但它在这里的定义是操作性的:状态可解码、可操纵、可迁移。它不意味着模型理解了交易动机、信息不对称或监管约束。用工程语言说,它有一个可用的内部坐标系;用交易语言说,它还不足以替代你对市场结构的判断。
06对中文读者的用法
这篇论文离实盘有距离,但它给的三个检查方法可以立刻用在任何「AI 预测市场」的产品上。
- 问对方:你的模型隐藏状态里,能不能用线性探针读出订单流失衡?读不出来的「理解」,多半只是模式记忆。
- 问迁移:换一只没训练过的标的,指标掉多少?只在一只票上有效的模型,不叫模型,叫拟合。
- 问操纵:把某个因子在表示空间里推一下,预测会不会按方向变?只会「读」不会「推」的系统,不能做反事实。
- 看到 R² 时先开根号:0.59 的 R² 是 0.77 的相关,也是 64% 的残差;两个数字都要看。
- 把「模拟得像」和「理解得深」分开评估:前者看分布距离,后者看探针与干预,两套指标不能互相替代。
对做量化的人,还有一个更实际的推论:如果 OFI 能以线性方式从一个小模型的状态里读出来,那么「用大模型提取因子」这件事可能没有想象中那么必要——一个线性探针加一个 8M 参数的序列模型,就能拿到相当一部分信息。真正的增量不在模型大小,而在你问的问题是否对准了市场的结构。
07一句话结论
这篇论文的价值不在于「AI 懂了市场」,而在于它给了一个可执行的检验:如果模型的状态里读不出订单流失衡、推不动它的预测,那么它生成得再像,也只是一个高级的复读机。
08延伸阅读
· arXiv:2610.28753,Mohl 等九人,Understanding the Inner Workings of a State-Space Foundation Model for Limit Order Books,https://arxiv.org/abs/2610.28753(v1,2026-10-29;ICAIF ’26 接收)
· 本页短引共 5 处,逐字摘自该页摘要;8.2M 参数、八只美股大盘股、R²≈0.59、跨股票迁移与「单调 in dose」均以摘要为准;摘要中的 $R^2$ 记号在短引里写作 R^2
· 第 04 节的相关系数、残差比例、6.25% 概率与参数量/数据量比值均为本站按 R² 定义所做的算术演示,不是论文数据
访问日期:2026-10-29。文中英文短引均摘自所列公开原文,译文与注释为本站所加;凡标注「我们的复算」「演示性算例」处均为按公开口径的算术推导,不是原作者结论。原文版权归原作者与发布方所有,本页为摘译与独立分析,不构成投资建议。
常见问题
订单流失衡(OFI)是什么,为什么用它当探针?
OFI 是主动买单与主动卖单在数量上的差额,在微观结构文献里是解释秒级价格变动最稳定的变量之一。用它当探针的好处是:它有明确的经济含义、可当期计算,而且如果模型真的学到了市场状态,这个量应该存在于它的内部表示里。
R²≈0.59 算高还是低?
取决于比较对象。相对随机初始化或打乱数据的对照,0.59 很高;相对「完全解释」的目标,它仍有 41% 的方差没被覆盖,残差标准差约为原始波动的 64%。所以它证明「信息在」,但不证明「信息全」。
「可操纵」为什么比「可解码」更重要?
可解码只说明信息存在于隐藏状态中,可能是被动残留;可操纵说明沿该特征方向推动状态会改变模型的下一步预测,而且随推动幅度单调变化,这更接近「模型在生成时真的使用了这个量」。这是「世界模型」说法的核心证据。
这类模型能直接用来做交易吗?
摘要层面看不到任何交易回测或收益结果,论文的目标是可解释性而不是策略。即便表示可用,落地还需要解决延迟、成本、以及「表示稳定但预测不准」的问题。把它当成理解工具,而不是信号源,是更稳妥的读法。
本文为公开预印本的摘译与独立分析,不构成投资或法律建议。英文短引逐字摘自 arXiv 摘要页(访问日期 2026-10-29),译文与注释为本站所加;标为「我们的复算」处均为按公开定义设定的算术演示,不是原作者结论。 最后更新:2026-10-29。